Architettura AI / 5 min di lettura
AI ibrida: scegliere tra locale e cloud mantenendo il controllo sui dati
Assegnare ogni attività al modello adatto richiede regole sui dati, strumenti controllati e una misura della qualità del lavoro completato.
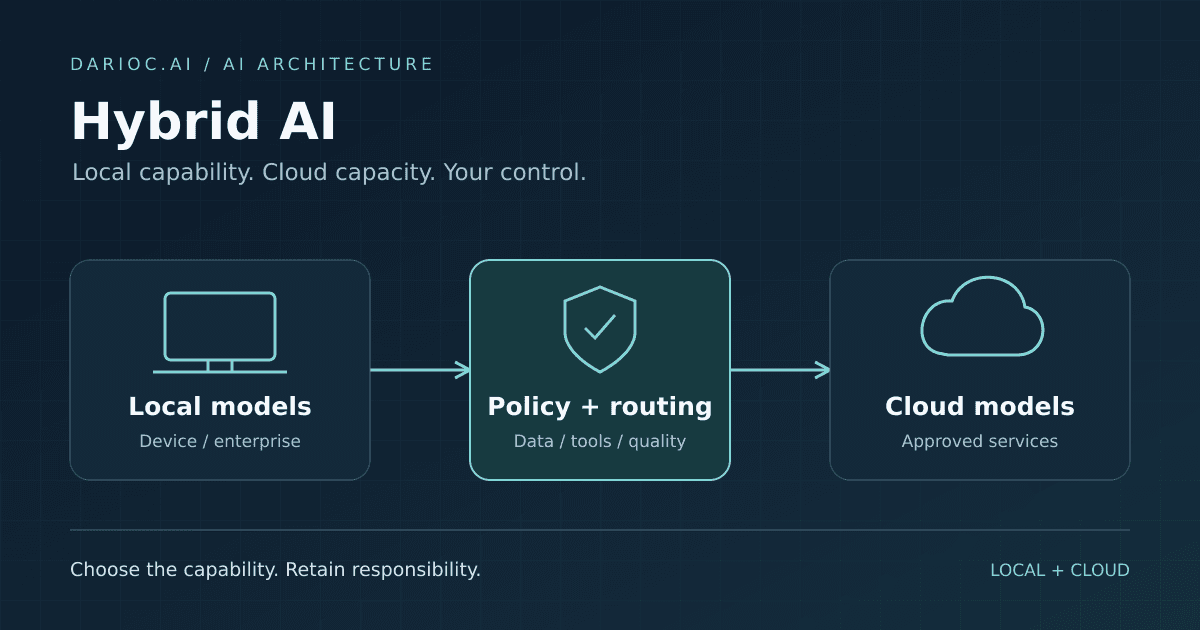
L'AI ibrida è un'architettura che combina modelli eseguiti su dispositivi o infrastrutture locali con modelli accessibili attraverso servizi cloud. Le attività vengono assegnate all'ambiente più adatto in base ai dati coinvolti, alla qualità richiesta e alle risorse disponibili. La scelta può essere effettuata dall'utente oppure da un sistema di instradamento, secondo regole definite.
Un assistente di sviluppo, per esempio, può utilizzare un modello locale per generare test su codice riservato e un servizio cloud autorizzato per analizzare documentazione pubblica. I due ambienti fanno parte dello stesso flusso di lavoro, ma non devono necessariamente elaborare entrambi ogni richiesta. Il vantaggio consiste nello scegliere una capacità adeguata al compito e ai vincoli dell'impresa, anziché affidare tutto allo stesso modello.
Consideriamo un team che deve correggere un modulo di un'applicazione cliente. Il codice contiene logiche proprietarie e l'assistente può leggere i file, proporre una modifica ed eseguire i test. Prima di iniziare, il team deve decidere quali informazioni può utilizzare, dove elaborarle e come verificare il risultato.
Prima il perimetro dei dati, poi il modello
Il team stabilisce che il codice del cliente può essere elaborato soltanto sul dispositivo o sull'infrastruttura aziendale autorizzata. La documentazione pubblica, invece, può essere inviata anche a servizi esterni approvati. Le credenziali vengono escluse dal contesto dell'assistente.
Queste regole delimitano le opzioni prima ancora di valutare la qualità dei modelli. Se il modello locale non risolve il problema, trasferire automaticamente il repository a un provider esterno violerebbe il perimetro stabilito. Le alternative sono utilizzare un servizio aziendale consentito, preparare un esempio privo di informazioni riservate oppure affidare il passaggio allo sviluppatore.
Il routing deve scegliere tra destinazioni autorizzate, non aggirare i vincoli quando il compito diventa difficile. Per routing si intende l'assegnazione delle richieste a modelli diversi secondo criteri definiti. La complessità è uno di questi criteri, insieme alla riservatezza e alle risorse disponibili.
Integrare il modello nel flusso di sviluppo
La selezione di modelli locali nella GitHub Copilot CLI offre un esempio di questa integrazione. L'annuncio GitHub del 7 ottobre 2026 descrive la possibilità di individuare modelli attraverso un'istanza Ollama già in esecuzione e utilizzarli nella sessione.
Il team deve installare separatamente runtime e modello, verificare l'endpoint e scegliere un modello che supporti streaming e chiamate agli strumenti. La selezione manuale resta distinta dal routing automatico: lo stesso annuncio richiama un instradamento intelligente con modelli locali, rinviando alle informazioni sulla disponibilità. Sono quindi capacità da verificare nella configurazione adottata, non intercambiabili.
Per il modulo del cliente, il primo passo può essere una scelta esplicita del modello locale. Automatizzare la selezione viene dopo, quando il team ha già chiarito quali richieste può gestire e quali richiedono un'altra risorsa autorizzata.
Controllare anche gli strumenti
Il modello locale propone una correzione. Per provarla, l'assistente esegue un comando che potrebbe scaricare dipendenze o contattare un servizio esterno. L'inferenza è locale, ma il flusso di lavoro può comunque generare traffico di rete.
GitHub precisa che selezionare un modello locale non abilita automaticamente la modalità offline e non disattiva la telemetria. Anche un provider remoto può ricevere contesto quando è configurato come destinazione, nonostante l'impostazione offline della CLI. Occorre quindi controllare endpoint, telemetria e connessioni degli strumenti separatamente.
Il sandboxing locale di Copilot permette di limitare accessi a file, rete e altre capacità di sistema secondo le politiche applicate. Nel nostro scenario, il team può consentire la lettura del modulo e l'esecuzione dei test, mantenendo limitato l'accesso ad altre cartelle e destinazioni di rete.
La riservatezza dipende dall'intero percorso dei dati: modello, strumenti e servizi collegati. Un server MCP, che espone strumenti o fonti di dati all'assistente, rientra nello stesso controllo. Il permesso di elaborare un file non implica quello di trasmetterlo.
Confrontare il lavoro completato
Una volta definito il perimetro, il team può confrontare il modello locale con un servizio aziendale autorizzato sullo stesso compito. Il criterio principale è il tempo necessario per ottenere una modifica corretta e approvata, non soltanto la velocità di generazione.
La verifica comprende test superati, correzioni richieste e tempo di revisione. Lo sviluppatore controlla anche che i test rappresentino il requisito: una suite eseguita senza errori può comunque trascurare il comportamento che interessa al cliente.
Le risorse entrano nello stesso confronto. Per dimensionare la macchina bisogna considerare pesi del modello, memoria del contesto e consumo del runtime. La quantizzazione può ridurre la memoria occupata; qualità delle risposte e compatibilità hardware determinano se il compromesso è accettabile.
Il costo comprende hardware, energia, manutenzione e tempo del team. Le eventuali quote dipendono dalle condizioni del prodotto. Una risposta locale con molte correzioni può risultare meno conveniente di una risposta remota autorizzata che completa bene il lavoro, e viceversa.
Scegliere la capacità, mantenere la responsabilità
Nel lavoro del team, la scelta tra locale e cloud acquista significato quando protegge il codice del cliente e permette di ottenere una modifica affidabile. Il modello può cambiare; i vincoli sui dati e la responsabilità di chi approva il risultato devono restare chiari.
Questo sposta l'attenzione dalla potenza del singolo modello alla qualità del sistema che lo utilizza. Un'impresa dispone di maggiore autonomia quando può adottare una capacità migliore senza dover rinunciare alle proprie regole, affidarsi a trasferimenti impliciti o ricostruire ogni volta il processo di verifica.
Il valore dell'AI ibrida non è avere più modelli a disposizione, ma poter scegliere come utilizzarli senza cedere il controllo sul proprio lavoro. È questa capacità di scelta consapevole, più della posizione del modello, a rendere l'AI una risorsa affidabile per l'impresa.
Sull'autore
Dario Cargnino
Senior Pre-Sales Manager, Solution Architect e Agentic Engineer
Lavoro tra strategia AI, solution architecture e sistemi digitali enterprise, con particolare attenzione alla fiducia operativa, alla concretezza nella delivery e alla resilienza delle piattaforme nel lungo periodo.
Dati articolo
In sintesi
- Pubblicato
- 16 ottobre 2026
- Tempo di lettura
- 5 min di lettura
- Categoria
- Architettura AI
Argomenti